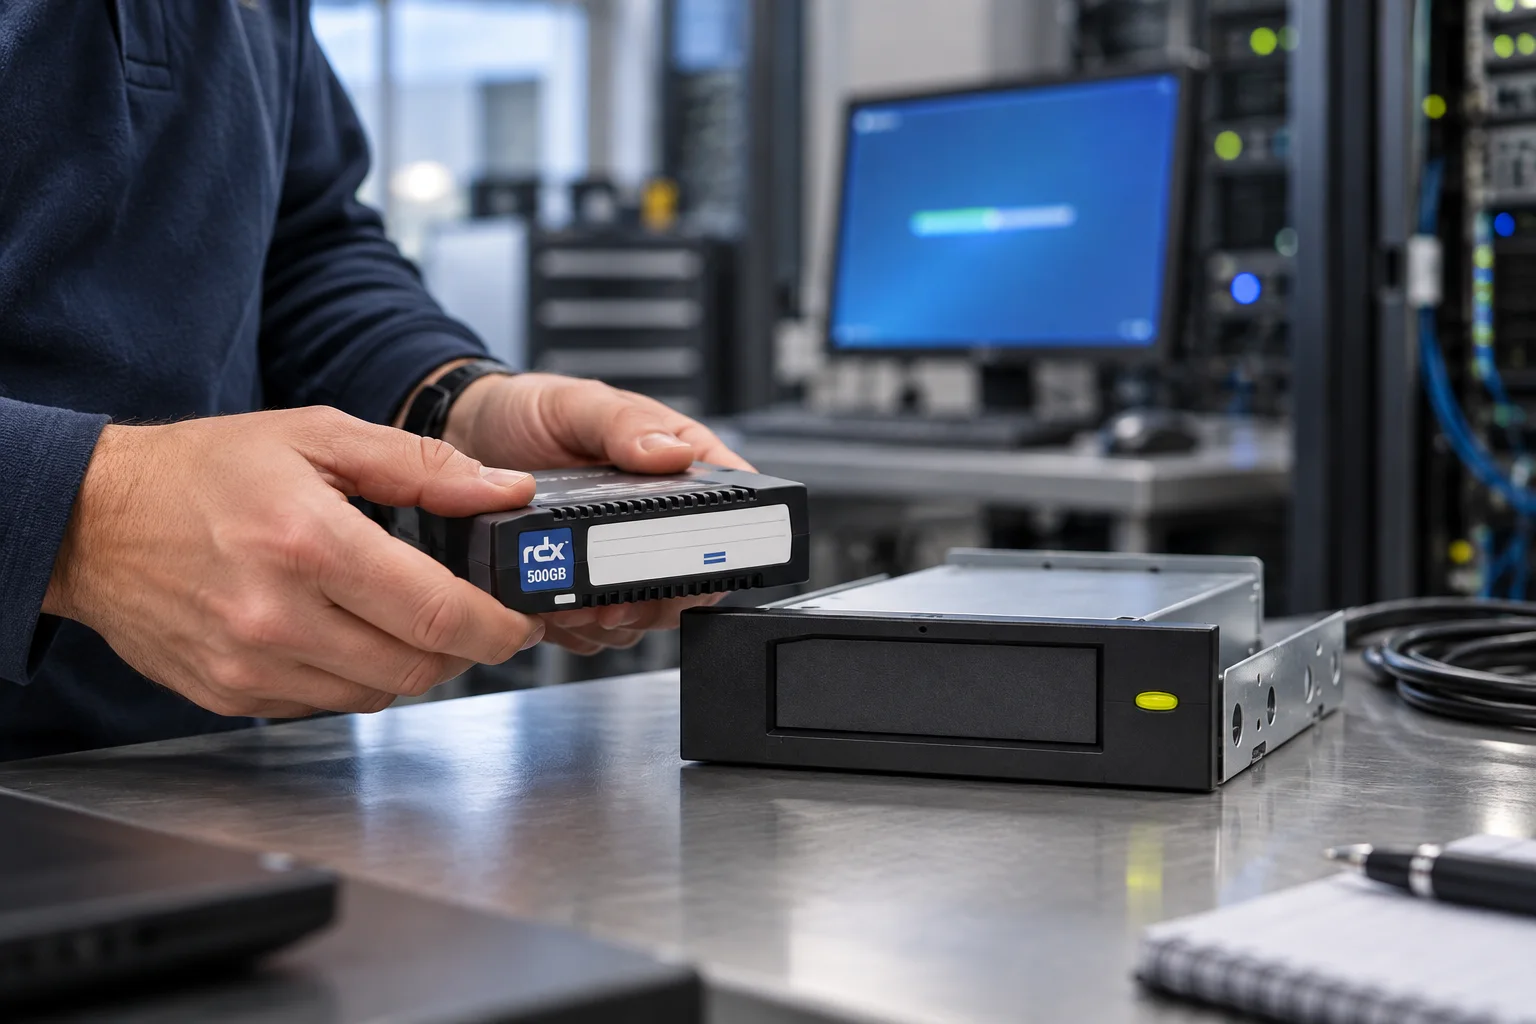
Une sauvegarde locale sur support amovible peut être très utile pour un poste critique, un petit serveur ou une agence qui doit pouvoir restaurer rapidement sans dépendre d’une connexion distante. Veeam Agent et un support RDX peuvent s’inscrire dans ce scénario à condition de construire une procédure complète : le logiciel lance la tâche, mais l’équipe doit encore organiser le média, son retrait et la preuve de restauration.
Définir ce qui doit être récupéré
Commencez par le besoin de reprise plutôt que par l’outil. Pour un poste, une sauvegarde complète peut être pertinente si l’objectif est de retrouver un environnement de travail après une panne matérielle. Pour un petit serveur, il faut aussi identifier les données applicatives, les configurations et les prérequis nécessaires à une reprise cohérente.
Notez le propriétaire du système, la perte de données acceptable et le délai de remise en service attendu. Ces éléments permettront de choisir une fréquence réaliste et de vérifier si le support prévu peut absorber le volume de sauvegarde.
Préparer le support et la rotation
Un média amovible ne devient pas une copie hors ligne par sa seule nature. Il faut prévoir ce qui se passe après la tâche : qui retire le média, où il est conservé, quel support revient pour le prochain cycle et comment l’opération est tracée.
Une rotation simple peut comporter plusieurs médias identifiés. L’un est utilisé pour la prochaine sauvegarde, un autre est conservé séparément après vérification et un troisième circule selon le calendrier défini. Le nombre de supports dépend de la fréquence, de la rétention et du délai de transport ; il ne doit pas être choisi au hasard.
Configurer puis vérifier le scénario
Lors de la configuration, vérifiez notamment :
- le périmètre réellement protégé ;
- la destination choisie et l’espace disponible ;
- les horaires qui ne perturbent pas l’activité ;
- les alertes en cas d’absence ou d’erreur de média ;
- la conservation des identifiants, clés et supports de récupération nécessaires.
Le premier succès affiché par le logiciel ne clôt pas le projet. Réalisez un test sur un fichier puis un test plus représentatif : retrouver le média, ouvrir le point de restauration, remettre les données à disposition et contrôler leur utilisation. Mesurez le temps complet et consignez les difficultés.
Prévoir les incidents ordinaires
La qualité d’une procédure se voit souvent dans les situations banales : le média prévu est resté au domicile d’un collaborateur, l’espace disponible est insuffisant, une tâche échoue pendant les congés ou le poste a été remplacé depuis la dernière sauvegarde. Pour chaque cas, écrivez une réponse simple. Elle doit indiquer qui est alerté, si un support de remplacement est autorisé, comment le retour à la rotation est contrôlé et à quel moment un test complémentaire devient nécessaire.
Cette partie évite que l’équipe improvise sous pression. Elle protège également la rétention : un support utilisé en urgence ne doit pas effacer la seule copie validée sans une décision explicite.
Faire correspondre les liens et les responsabilités
Le dossier de reprise ne se limite pas au média. Conservez, séparément du poste protégé, les coordonnées du responsable, le nom de la tâche, le chemin du registre de rotation et les éléments indispensables à l’accès. Si le dispositif utilise du chiffrement, prévoyez une conservation contrôlée des informations nécessaires à la récupération, sans les placer sur l’étiquette du support.
Pour une architecture plus complexe, une validation de la solution RDX, du logiciel et du mode de connexion doit être menée avant déploiement. La page Veeam Backup & Replication de Tandberg Data est la bonne entrée pour ce besoin ; cet article reste volontairement centré sur la méthode locale.
Éviter les faux sentiments de sécurité
Un support laissé connecté en permanence reste exposé à une erreur, à un compte compromis ou à un incident touchant le poste. De même, une copie chiffrée est inutilisable si la clé ou les accès ne sont pas disponibles au bon moment. La procédure doit donc prévoir une conservation séparée, des responsabilités claires et une vérification périodique.
Passer d’un test à une routine
Une fois le pilote validé, documentez le changement de média, la consultation des alertes et le test de restauration. Adaptez ensuite la fréquence aux besoins métiers. Si l’environnement se développe, le même raisonnement permettra de décider si une copie supplémentaire, une conservation hors site ou un objectif RPO/RTO plus formel devient nécessaire.
Pour aller plus loin
La méthode de rotation des supports précise l’organisation des médias. La checklist de test de restauration aide ensuite à transformer ce scénario en preuve mesurable.
Ce que le pilote doit prouver
Un pilote n’est pas validé parce qu’une première tâche est verte. Il est validé lorsqu’une personne désignée peut lire le registre, retrouver le bon média, restaurer le périmètre convenu et obtenir l’accord du propriétaire des données dans le délai visé. Vérifiez également qu’après le test une copie séparée et connue reste disponible. Cette preuve distingue une démonstration technique d’une continuité réellement exploitable.
Réviser le dispositif quand l’environnement change
Une nouvelle application, une croissance de volume, un changement de collaborateur ou une nouvelle contrainte de rétention modifient le risque. Une revue trimestrielle du registre, des alertes et du dernier test permet de détecter ces écarts. Le passage à une architecture plus complexe appelle alors une validation sur le site principal ; le blog conserve son rôle de méthode et de contrôle.
Partager ce guide